写了两年 Obsidian,笔记攒了几百篇。但每次想找"那个 XX 问题当时怎么想的",还是得翻文件夹、靠文件名猜。
向量数据库(RAG)火了之后我试了几轮,发现一个尴尬的事:它能回答"这篇文章讲了什么",但回答不了"A 和 B 之间有什么关系"。你问它"之前那篇提到的方案和这次的冲突在哪",它经常答非所问——因为它只在做文本相似度匹配,根本不知道你笔记里写的实体之间有什么联系。
后来我换了个思路:不做纯向量检索,先让 AI 把你笔记里的人和事抽出来、连成一张图,再基于这张图回答问题。搭完跑了两周,78 篇笔记索引成 3000 多个实体节点,跨文档问答确实比纯向量 RAG 好用。这篇文章讲清楚技术选型、部署步骤、踩过的坑,以及什么情况下值得搭。
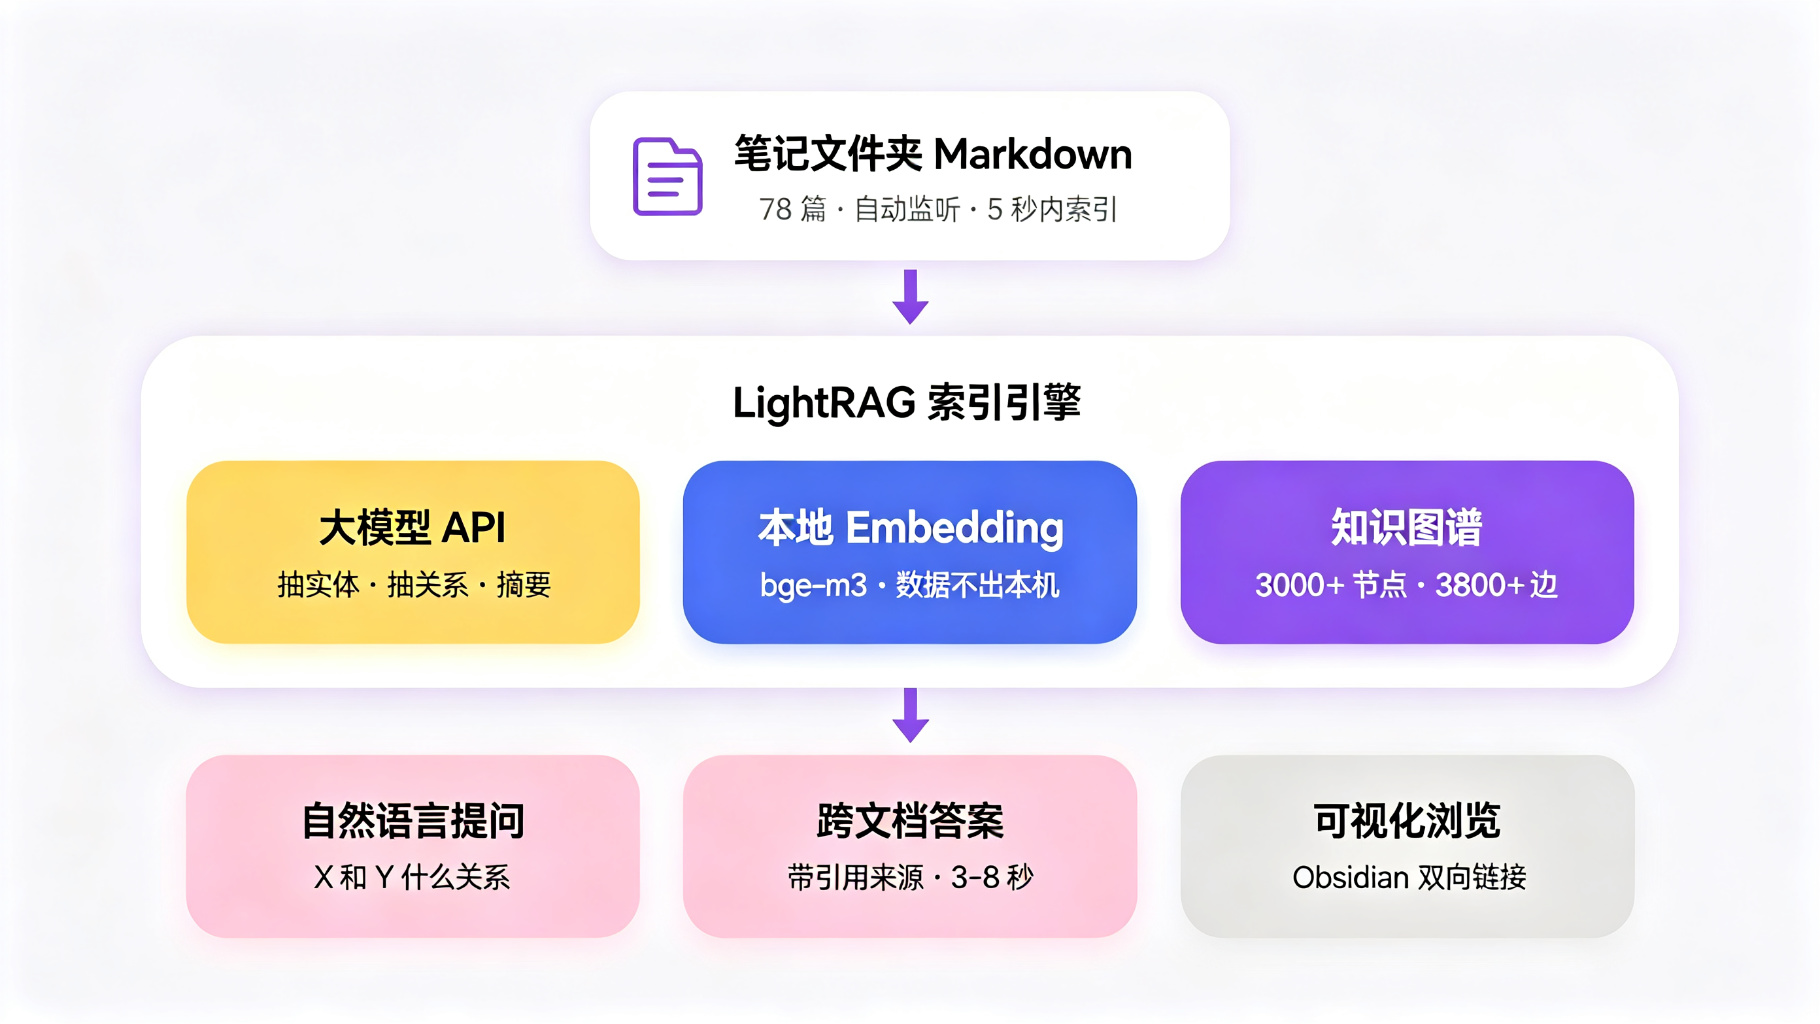
普通 RAG 和 GraphRAG 到底差在哪
普通 RAG 的流程:文档切块 → embedding → 存向量库 → 问题来了找最相似的几块 → 塞给大模型回答。
瓶颈在于相似不等于相关。两篇文章用词不同但讲同一件事,向量距离可能很远;反过来,两个词面相似但讲的是完全不同的东西,它又会误召回。它能回答"这篇文章讲了什么",但回答不了"A 和 B 之间有什么关系"。
GraphRAG 在索引阶段多做了一步:让大模型读你的每篇文档,把实体和关系抽出来,存成一张图。查询时除了向量召回,还沿着图遍历。
| 普通向量 RAG | GraphRAG(本文方案) | |
|---|---|---|
| 索引方式 | 文档切块 → 向量 | 抽实体+关系 → 图谱 + 向量 |
| 擅长回答 | "这篇文章讲了什么" | "X 和 Y 什么关系、有什么冲突" |
| 跨文档关联 | 弱(靠向量相似度) | 强(沿图遍历) |
| 索引成本 | 低(只 embedding) | 高(每篇调 LLM) |
| 适合文档量 | 几百到几万 | 几十到几千(LLM 成本可控) |
技术栈选型
| 组件 | 选型 | 为什么不选别的 |
|---|---|---|
| 图谱框架 | LightRAG 1.5.7 | 开源、支持中文、自带 Web UI 和多种查询模式 |
| LLM | DeepSeek API | 便宜,索引 80 篇几块钱;本地模型慢 |
| Embedding | Ollama + bge-m3 | 本地免费,中英混排友好 |
| 文件监听 | 20 行 Python | 5 秒轮询够用,不用装 watchman |
| 编辑器 | Obsidian | 双向链接 + 图谱视图 |
| 对外接口 | MCP stdio(100 行) | 官方不带 MCP,自写透明可控 |
查询模式怎么选
| 模式 | 走什么路径 | 适合什么问题 |
|---|---|---|
mix | 向量 + 图遍历 | 默认,最全面 |
local | 纯图遍历 | 查具体实体/术语,命中率最高 |
global | 全局摘要 | 问宏观策略 |
hybrid | 向量 + 图加权 | 介于 mix 和 local 之间 |
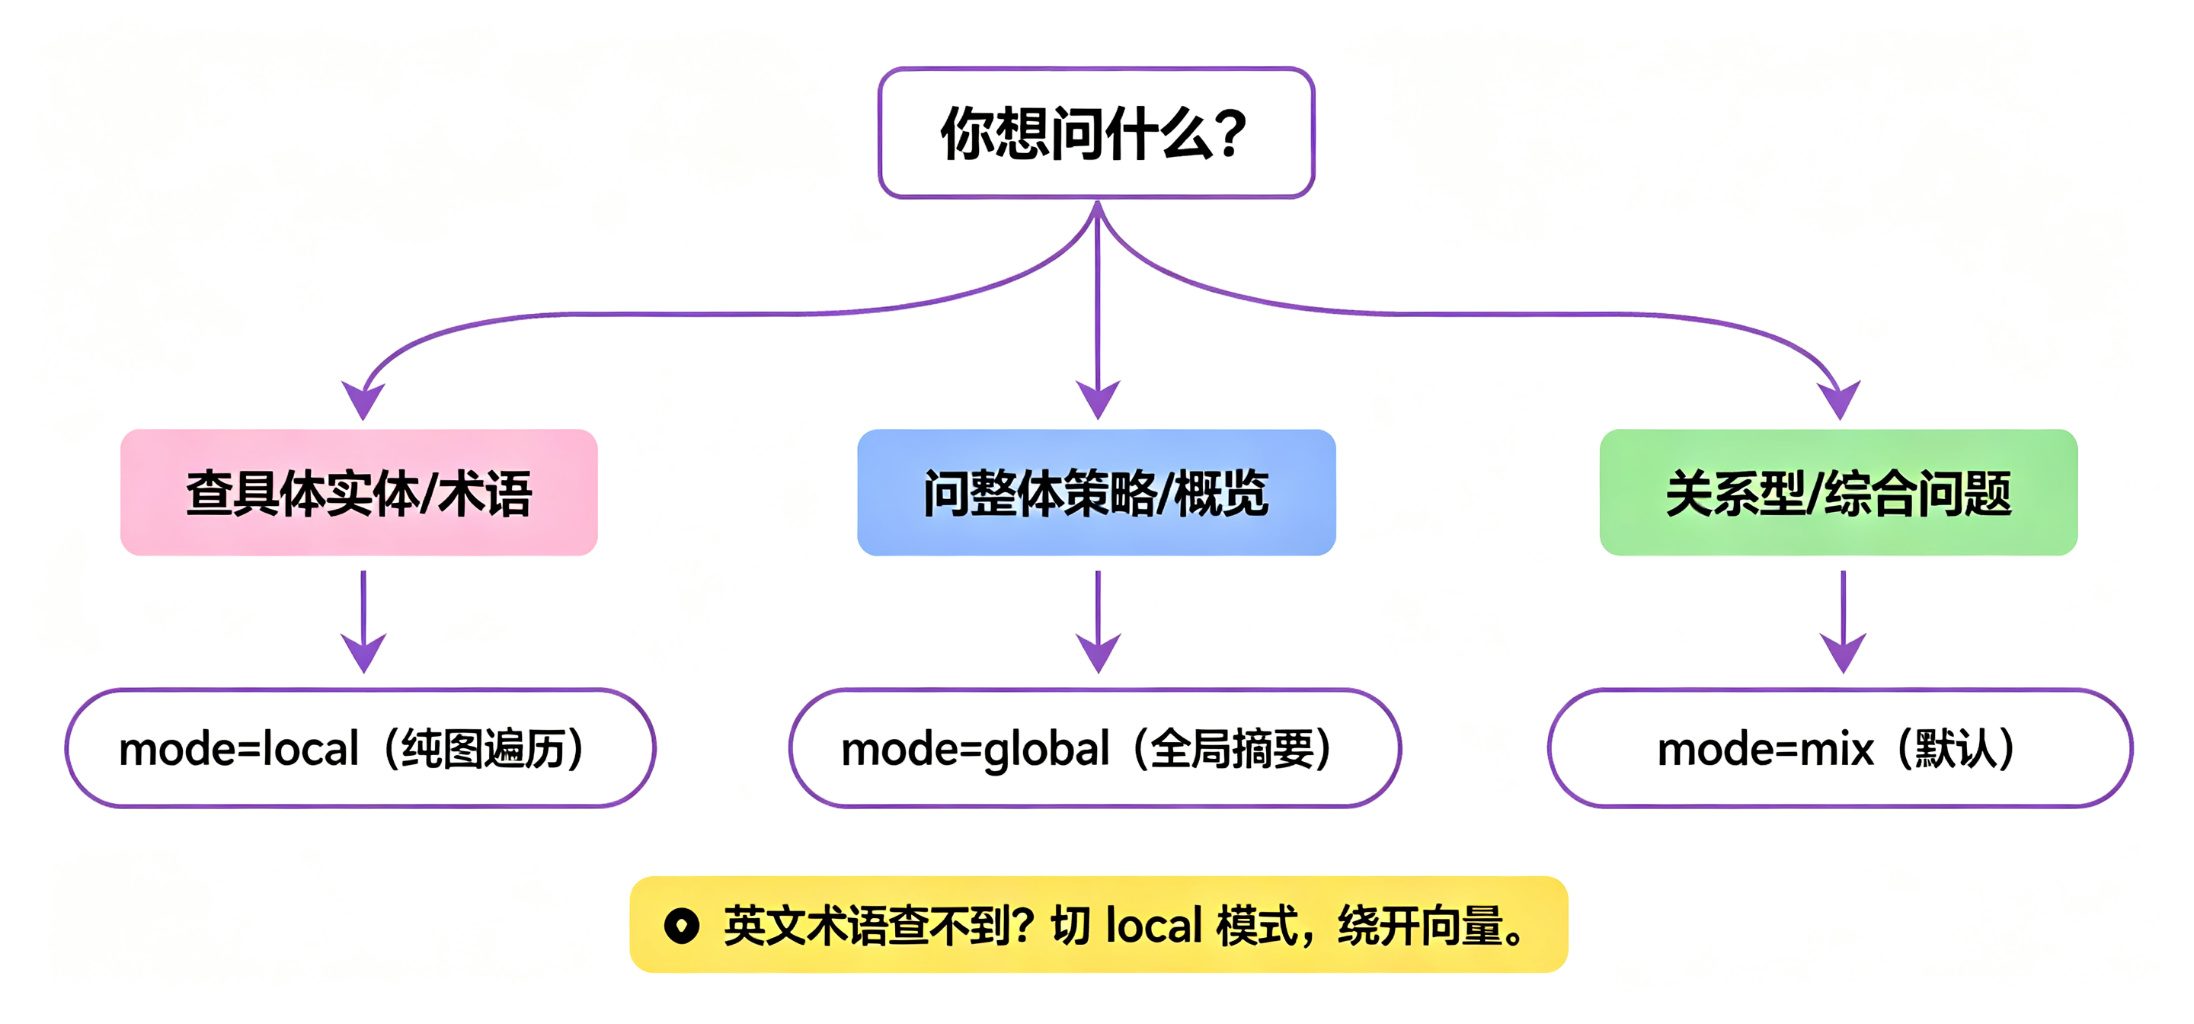
实测发现:查英文术语时优先用 local 模式。 hybrid 经常首轮答不出来——实体在图里但向量没带出来。切 local(纯图检索绕开向量),命中率明显提高。
两个 AI agent 怎么分工
这套系统不是单个 AI 在用,而是两个独立的 AI agent 共享同一个知识图谱。这是我觉得最有意思的部分:它们不直接对话,而是通过文件系统 + 知识图谱异步协作。
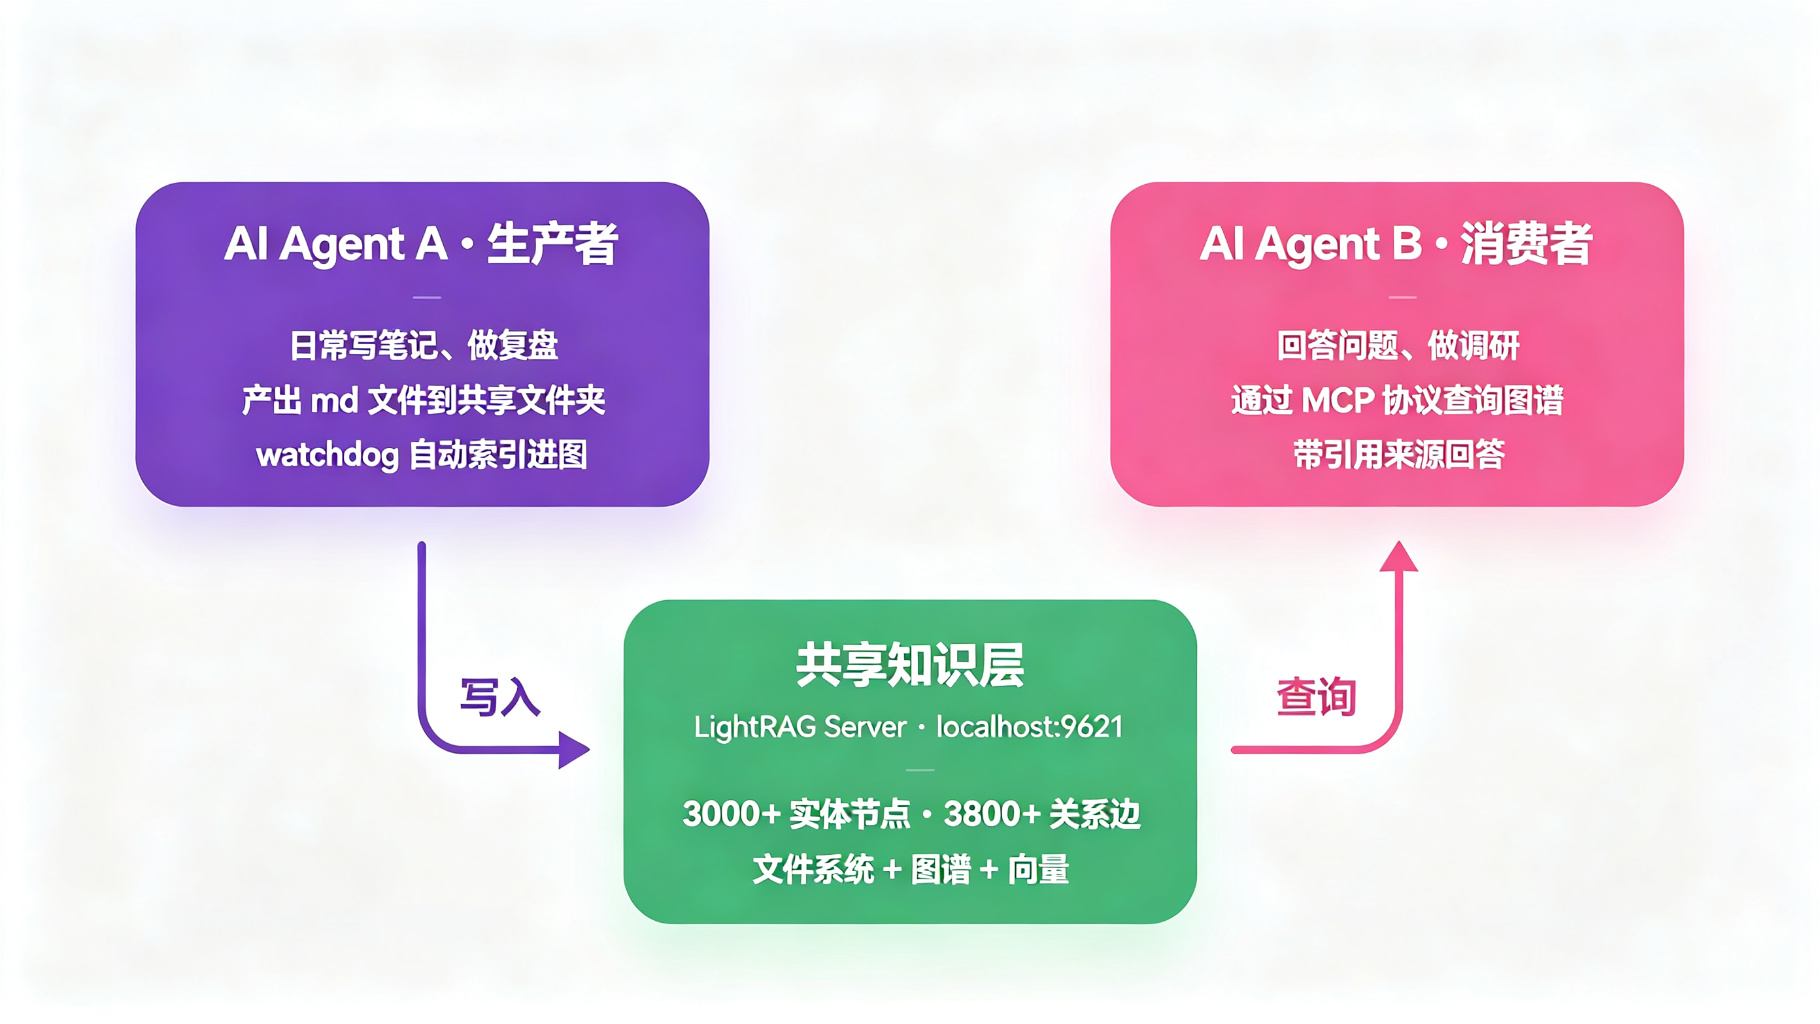
| Agent A(生产者) | Agent B(消费者) | |
|---|---|---|
| 主要工作 | 写笔记、做复盘、沉淀方法论 | 查资料、回答问题、做交叉验证 |
| 和图谱的关系 | 写入(自动索引新 md) | 查询(MCP 协议调用) |
| 技术接口 | 文件系统(md 落盘) | MCP stdio(6 个查询工具) |
| 不直接通信 | 两个 agent 不直接对话,靠共享文件系统 + 图谱异步协作 | |
这种设计的好处是解耦:生产者不用关心怎么查询,消费者不用关心怎么索引。新笔记写进去 5 秒就进图,另一个 agent 马上就能查到。
部署步骤
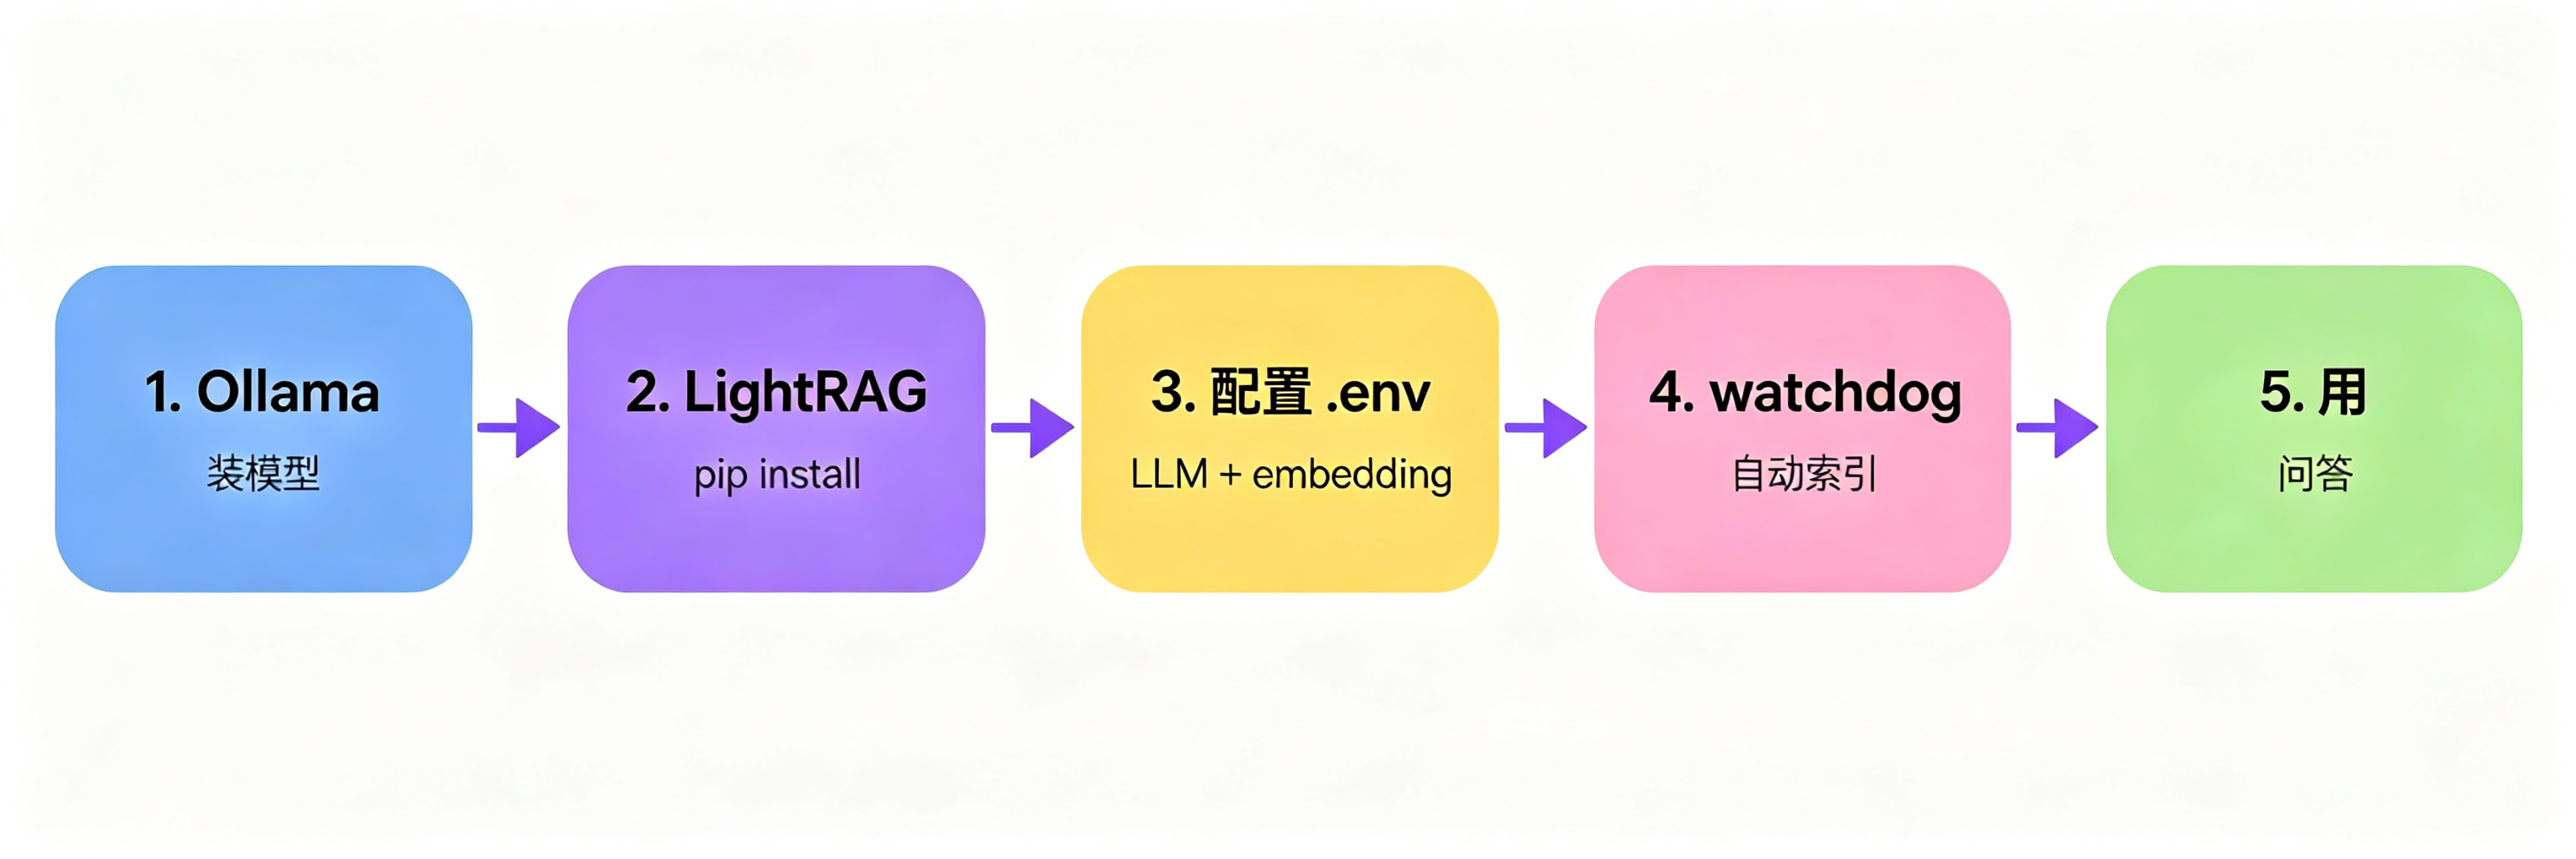
1. 装 Ollama 和 embedding 模型
ollama pull bge-m32. 装 LightRAG
pip install lightrag-hku

# .env 配置
# LLM_BINDING=openai
# OPENAI_BASE_URL=https://api.deepseek.com/v1
# EMBEDDING_BINDING=ollama
# EMBEDDING_MODEL=baai/bge-m3
3. 启动 Server
lightrag-server --port 96214. watchdog 自动索引(20 行)
while True:
    for f in Path(WATCH_DIR).rglob("*.md"):
        h = file_hash(f)
        if f"{f}:{h}" not in seen:
            requests.post("http://localhost:9621/documents/text",
                json={"text": f.read_text(encoding="utf-8"),
                      "file_source": str(f)}, timeout=120)
            seen.add(f"{f}:{h}")
    time.sleep(5)
五个踩过的坑
坑 1:MCP SDK 版本不对。 pip install mcp 默认装 2.x,API 全变了。pin 到 <2。
坑 2:COS 源站类型选错。 必须选"静态网站源站",选错了 GET / 返回 403。
坑 3:开机自启别用任务计划程序。 用户权限会被拒,用 Startup 文件夹 VBS。
坑 4:别手改 Electron 配置。 Obsidian 的 vault 配置手写会被覆盖,走 UI。
坑 5:embedding 要匹配内容语言。 纯英文模型中文检索差,换 bge-m3 改善明显。
什么情况下值得搭
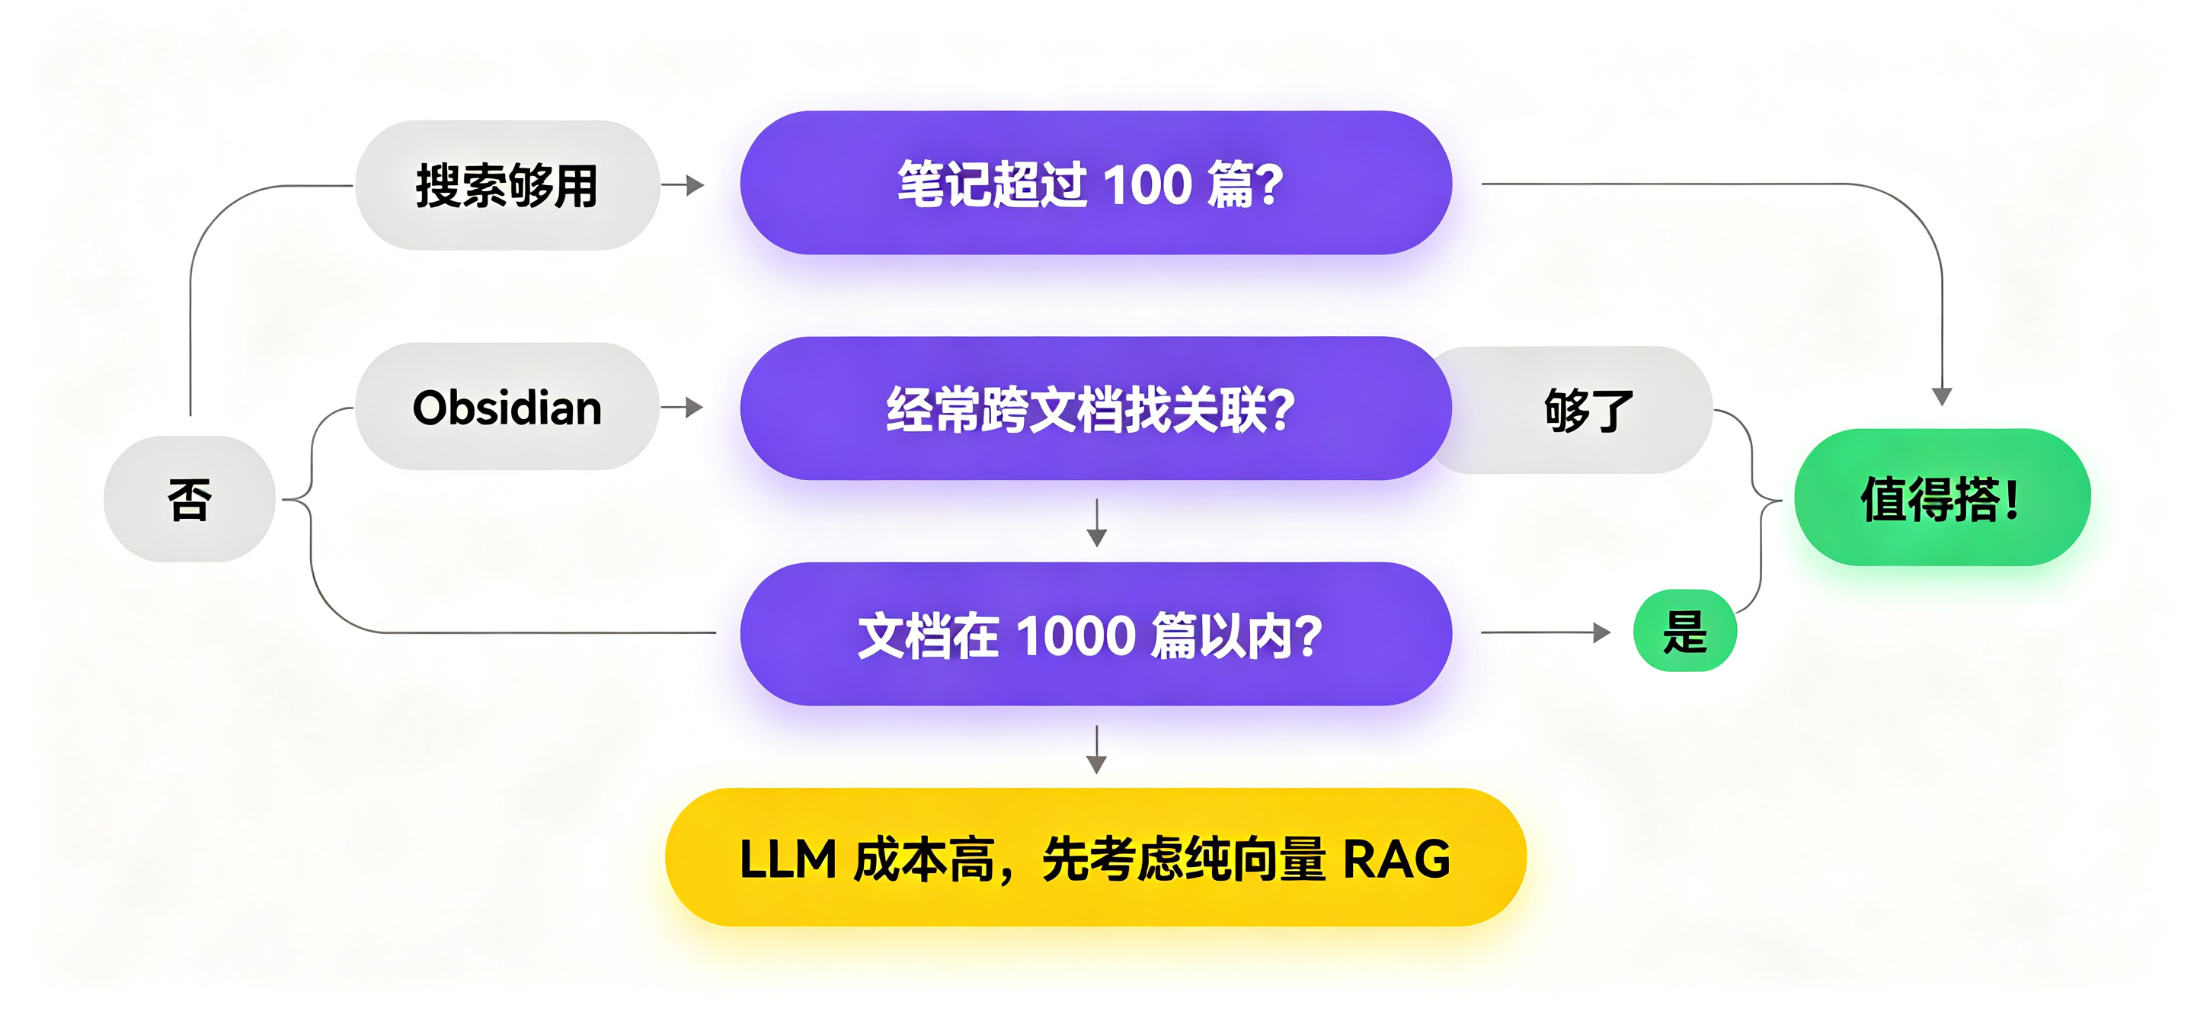
| 条件 | 不够(别搭) | 值得搭 |
|---|---|---|
| 笔记量 | 几十篇,搜索够用 | 过百,经常跨文档找关联 |
| 笔记结构 | 零散记录、待办 | 项目复盘、方法论、技术调研 |
| 成本 | 几万篇,LLM 成本高 | 几百篇以内,成本可忽略 |
78 篇笔记索引完:3000+ 实体节点、3800+ 关系边、索引约 20 分钟、API 成本几块钱。查询响应 3-8 秒。
现在的日常
新笔记写进文件夹,5 秒内自动进图。想查直接在 AI 对话框里问——背后是 MCP 协议调本地服务。写笔记时 Obsidian 自动关联。整个栈开机自启,重启不用管。
最关键的变化不是"能搜索了",而是笔记不再是孤岛。